[논문 리뷰] LLAMA 1

들어가며
최근에 하루가 멀다하고 모델 테크니컬 리포트가 쏟아지고 있다. 하지만 요즘 논문 읽기를 AI에게 의존하다보니 점점 기술을 내 것으로 소화하는 힘이 약해지고 있어 고민이었다.
마침 가짜연구소에서 LLM Technical Report 읽기 스터디를 진행한다고 해서, 그간 내게 부족했던 논문 읽기와 정리를 다듬을 수 있는 좋은 기회라 생각되어 참여하고 있다. LLAMA 1부터 중요한 테크니컬 리포트 들을 매주 파트별로 읽고 정리해서 발표하고 있다.

그리고 개인적으로 매주 논문들의 핵심을 블로그에 작성해보려고 한다.
그래서 오늘 첫 시작은 LLaMa 1 페이퍼이다. 부끄럽지만 LLaMA 3 모델이 한창 핫할 때 사용만 해보고, 정작 LLaMA 시리즈 모델의 논문을 제대로 읽어본 적이 없다.. ㅎㅎ 오픈 모델 진영의 한 시대를 이끌어 갔던 모델인 만큼 기대가 된다.
Introduction
2026년 지금도 마찬가지이지만, 당시 2023 년은 LLM 시장의 화두는 Scaling Law이다. 모델의 성능은 모델의 구조보다는 모델의 파라미터 크기 (N), 데이터셋 크기 (D), 학습 연산량 (C)의 3가지의 Power Law에 달려 있다는 것이다. 하지만 당연하게도 3가지를 모두 늘릴 수 있으면 당연히 좋겠지만, 우리의 예산 (Budget)은 한정되어 있으니 선택과 집중이 필요했다.
Llama는 이 지점에서 "더 작은 모델을 더 오래 학습"하는 전략을 선택했다. 기존 Chinchilla에서는 모델과 학습 토큰을 일정 비율로 함께 증가시켜야 함을 주장했지만, 저자들은 서비스 관점에서는 "빨리 학습되는 모델"보다, 학습은 더 오래시키더라도, 더 작은 모델에서도 높은 성능을 달성시키는 것에 집중하였다.
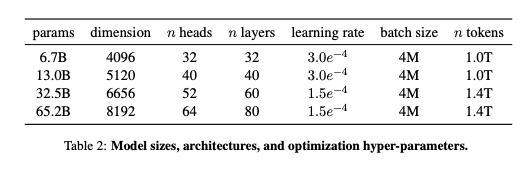
그 결과 아래 표와 같이 Chincilla에서는 70B 모델 사이즈에 1.4T를 제안했지만 Llama 모델은 7B라는 10배 적은 사이즈에 앞서 모델과 유사한 1T의 토큰을 태우는 보다 길게 학습하는 전략을 가져갔다.
시점 | 관점 | 선택 | 예시 (파라미터당 토큰) |
|---|---|---|---|
Kaplan (2020) | 모델의 크기가 성능을 가장 많이 올린다고 봄 | 모델을 크게, 학습은 짧게 | GPT-3 175B · 300B 토큰 (약 2) |
Chinchilla (2022) | 학습 비용: 정해진 GPU 예산으로 가장 좋은 모델 만들기 | 모델과 토큰을 함께 키움 | Chinchilla 70B · 1.4T (약 20) |
LLaMA 1 (2023) | 서비스(추론) 비용: 원하는 성능을 가장 작은 모델로 내기 | 모델은 작게, 학습은 오래 (학습 비용은 더 듦) | LLaMA 7B · 1T (약 150) |
Data
Llama는 공개되어 있는 데이터를 전처리하여 사용했으며 규모는 1.4T이다. 아쉽게도 논문에 어떠한 근거로 각 소스들의 믹스쳐를 구성했는지는 공개되어 있지 않다. 참고로 Llama의 데이터를 재구현한 RedPajama라는 프로젝트도 있다.
소스 | 비율 | epochs | 무엇 | 전처리 |
|---|---|---|---|---|
CommonCrawl | 67.0% | 1.10 | 웹 (영어) | 중복 제거 + 분류기 |
C4 | 15.0% | 1.06 | 다르게 필터링한 웹 | 휴리스틱 품질 필터 |
GitHub | 4.5% | 0.64 | 코드 | 라이선스 필터, 파일 중복 제거 |
Wikipedia | 4.5% | 2.45 | 20개 언어 | 링크·서식 제거 |
Books | 4.5% | 2.23 | Gutenberg + Books3 | 책 단위 중복 제거 |
ArXiv | 2.5% | 1.06 | 논문 LaTeX | 참고문헌·주석 제거 |
Stack Exchange | 2.0% | 1.03 | Q&A | 답변을 점수순 정렬 |
토크나이저로는 BPE(SentencePiece)에 Vocab Size는 32K를 사용했다. 숫자는 한 글자씩 쪼개고 (1234 -> <1> ,<2> , <3>, <4>), 만약 모르는 글자가 등장하면 byte로 쪼개는 기법 (뷁 -> <0xEB>, <0xB7>, <0x81>)을 적용했다.
Architecture
아키텍처에서도 새로운 구조를 제안하는 것이 아닌, 기존에 제안된 검증된 구조들을 채택하여 조립하였다.
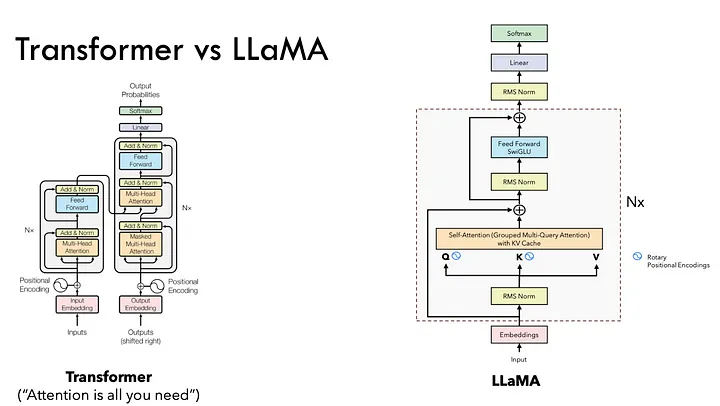
주요 특징은 다음과 같다.
정규화, Activaiton, Postisional Embedding은 각각은 후속 모델에서도 중요하고 계속 바뀌는 부분이라 이 후 포스트에서 다시 다뤄보려고 한다.
원 Transformer | LLaMA | 장점 | 출처 | |
|---|---|---|---|---|
Normalization | Post-norm, LayerNorm | Pre-norm, RMSNorm | 학습 안정성, 계산 절약 | GPT-3 |
FFN Activation | ReLU | SwiGLU | 같은 크기에서 더 좋은 성능 | PaLM |
Positional Embedding | absolute positional embeddings | RoPE | 상대 위치를 자연스럽게 반영 | GPTNeo |
또한 효율적인 학습을 위해 아래 기법들을 사용했다. 이를 통해 65B 모델을 2048장의 A100 (80GB Vram)에서 21일만에 학습 시킬 수 있었다.
기법 | 하는 일 |
|---|---|
메모리 효율 causal attention (xformers) | 어차피 가려질 미래 토큰 점수는 계산·저장 안 함 |
Activation checkpointing | 비싼 중간값은 저장해두고 나머지는 backward에서 다시 계산 |
Model·sequence parallelism | 큰 모델을 여러 GPU에 나눠 올림 |
Evaluation
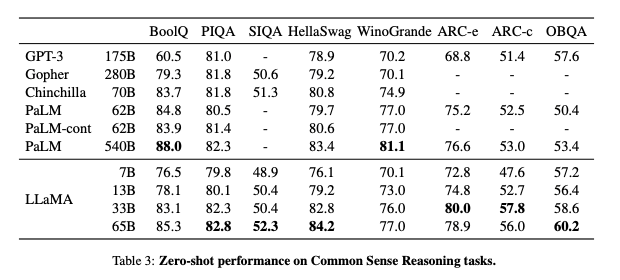
그 결과 Llama 모델은 작은 사이즈 (13B, 65B)에서도 더 큰 체급의 GPT-3 , Chincilla, PaLM 모델을 상회하는 성능을 보여주었다. 측정한 벤치마크의 종류는 아래와 같고, 본 포스트에는 Common Sense Reasoning 벤치만 수록하였다.
채점 방식은 크게 두가지로 나뉜다.
- 보기 고르기(likelihood): 보기마다 모델이 매기는 확률을 비교해 가장 높은 것을 답으로. 긴 보기가 불리하지 않도록 길이로 정규화 (ex. HellaSwag, PIQA)
- 생성: 답을 생성하고 정답과 일치하는지(exact match), 코드는 테스트 통과로(pass@k) 등으로 채점 (ex. NaturalQuestions, HumanEval, GSM8k)
도메인 | 벤치마크 | 채점 |
|---|---|---|
상식 추론 (8개) | BoolQ · PIQA · SIQA · HellaSwag · WinoGrande · ARC-e/c · OBQA | 보기별 likelihood |
Closed QA | NaturalQuestions · TriviaQA | 생성 후 exact match |
독해 | RACE | likelihood |
수학 | MATH · GSM8k | exact match, maj1@k |
코드 | HumanEval · MBPP | pass@k |
종합 지식 | MMLU | likelihood, 5-shot |
Conclusion
이번 시간에는 Llama 1 테크니컬 리포트에 대해 살펴보았다. 사실 학술 논문과 달리 Why보다는 How와 결과에만 집중하는 부분이 있어, 왜 이렇게 결정했는지는 궁금한 부분도 꽤나 있었다. 하지만 기존 Transformer 논문을 바탕으로 앞으로 Technical Report를 읽어가는데 좋은 뼈대가 되는 페이퍼라고 생각한다.
아직 디테일한 부분들은 추가로 공부해야할 내용들이 많다. (RoPE, Optimizer, Instruction Tuning) 등등
차차 블로그에 계속 쌓아나가려고 한다. 다음 시간에는 Llama 2 논문을 정리해보고자 한다.